Hugging Face 发布 HF Skills,让 Claude Code 直接微调开源 LLM
We Got Claude to Fine-Tune an Open Source LLM
Hugging Face 发布 HF Skills,通过 hf-llm-trainer 等技能让 Claude Code、Codex、Gemini CLI 直接提交云端 GPU 微调任务并推送到 Hub。技能支持 SFT、DPO 和 GRPO,可训练 0.5B 到 70B 参数模型并转换为 GGUF 本地部署,官方示例微调 Qwen3-0.6B 约需 20 分钟、0.30 美元。
官方给出从数据校验、选卡到提交训练和转 GGUF 的完整流程与成本区间,可直接照做。
我们为 Claude 赋予了使用名为 HF Mirror Skills 的新工具微调语言模型的能力。它不仅能编写训练脚本,还能实际向云端 GPU 提交任务、监控进度,并将训练完成的模型推送到 HF Mirror Hub。本教程将向你展示其工作原理以及如何自己使用它。
Claude Code 可以使用“技能”——打包好的指令、脚本和领域知识——来完成专门任务。
hf-llm-trainer技能教会 Claude 训练所需的一切知识:根据你的模型规模选择哪款 GPU、如何配置 Hub 认证、何时使用 LoRA 而非全量微调,以及如何处理成功训练运行中涉及的数十项其他决策。
有了这个技能,你可以这样告诉 Claude:
Fine-tune Qwen3-0.6B on the dataset open-r1/codeforces-cots
然后 Claude 会:
- 验证你的数据集格式
- 选择合适的硬件(0.6B 模型用 t4-small)
- 使用并更新带有 Trackio 监控的训练脚本
- 将任务提交到 HF Mirror Jobs
- 报告任务 ID 和预估成本
- 在你询问时检查进度
- 出问题时帮你调试
模型在 HF Mirror GPU 上训练,而你可以去做其他事情。训练完成后,你微调好的模型会出现在 Hub 上,随时可用。
这不是玩具演示。该技能支持与生产环境相同的训练方法:监督微调、直接偏好优化,以及带可验证奖励的强化学习。你可以训练从 0.5B 到 70B 参数的模型,将其转换为 GGUF 以便本地部署,并运行结合不同技术的多阶段流水线。
安装与设置
开始之前,你需要:
- 一个拥有 Pro 或 Team / Enterprise 套餐的 HF Mirror 账户(Jobs 需要付费套餐)
- 一个来自 hf-mirror.com/settings/tokens 的写入权限令牌
- 一个编码代理,如 Claude Code、OpenAI Codex 或 Google 的 Gemini CLI
HF Mirror 技能兼容 Claude Code、Codex 和 Gemini CLI。对 Cursor、Windsurf 和 Continue 的集成也即将推出。
Claude Code
- 将该仓库注册为市场插件:
/plugin marketplace add huggingface/skills
- 要安装技能,请运行:
/plugin install <skill-folder>@huggingface-skills
例如:
/plugin install hf-llm-trainer@huggingface-skills
Codex
- Codex 会通过
AGENTS.md文件识别这些技能。你可以用以下命令验证指令是否已加载:
codex --ask-for-approval never "Summarize the current instructions."
- 更多详情,请参阅 Codex AGENTS 指南。
Gemini CLI
该仓库包含
gemini-extension.json以集成 Gemini CLI。在本地安装:
gemini extensions install . --consent
或使用 GitHub URL:
gemini extensions install https://github.com/huggingface/skills.git --consent
- 更多帮助请参阅 Gemini CLI 扩展文档。
连接到 HF Mirror
你必须使用写入权限令牌向你的 HF Mirror 账户进行身份验证,以便该任务能够创建模型仓库。
设置你的令牌:
hf auth login
# or
export HF_TOKEN=hf_your_write_access_token_here
配置 HF Mirror MCP Server 以使用你的写入令牌,将其发送在
HF_TOKEN或Authorization: BearerHTTP 标头中。对于 Claude Code:
claude mcp add --transport http hf-skills https://hf-mirror.com/mcp?bouquet=skills --header "Authorization: Bearer $HF_TOKEN"
你的第一次训练运行
让我们走一遍完整示例。我们将微调一个小模型以了解完整工作流程,然后探索更高级的功能。
指示编码代理进行微调
从一条简单明确的指令开始,微调某个特定模型
Fine-tune Qwen3-0.6B on the open-r1/codeforces-cots dataset for instruction following.
编码代理会分析你的请求并准备训练配置。对于演示数据集上的 0.6B 模型,它会选择 t4-small——对于该模型规模来说 GPU 足够,而且是可选的最便宜方案。
open-r1/codeforces-cots数据集是一个包含 Codeforces 题目和解答的数据集。它是用于指令微调模型以解决高难度编码问题的好数据集。
这对视觉语言模型也适用!你只需运行“Fine-tune Qwen/Qwen3-VL-2B-Instruct on llava-instruct-mix”
提交前审查
在你的编程代理提交任何内容之前,你会看到配置:
I'll fine-tune Qwen/Qwen3-0.6B on open-r1/codeforces-cots using SFT.

Configuration:
- Hardware: t4-small (~$0.75/hour)
- Estimated time: ~20 minutes
- Estimated cost: ~$0.30
- Output: username/qwen-codeforces-cots-sft

The model will be pushed to Hub automatically. Should I submit?
这是你调整任何内容的机会。更改输出仓库名称、选择不同的硬件,或让 Claude 修改训练参数。一旦你批准,代理就会提交任务。
例如,你可以让代理先试运行一次:
Do a quick test run on 100 examples.
跟踪进度
提交后,你会获得任务详情:
✅ Job submitted successfully!

Job ID: abc123xyz
Monitor: https://hf-mirror.com/jobs/username/abc123xyz

Expected time: ~20 minutes
Estimated cost: ~$0.30

View real-time metrics at: https://hf-mirror.com/spaces/username/trackio
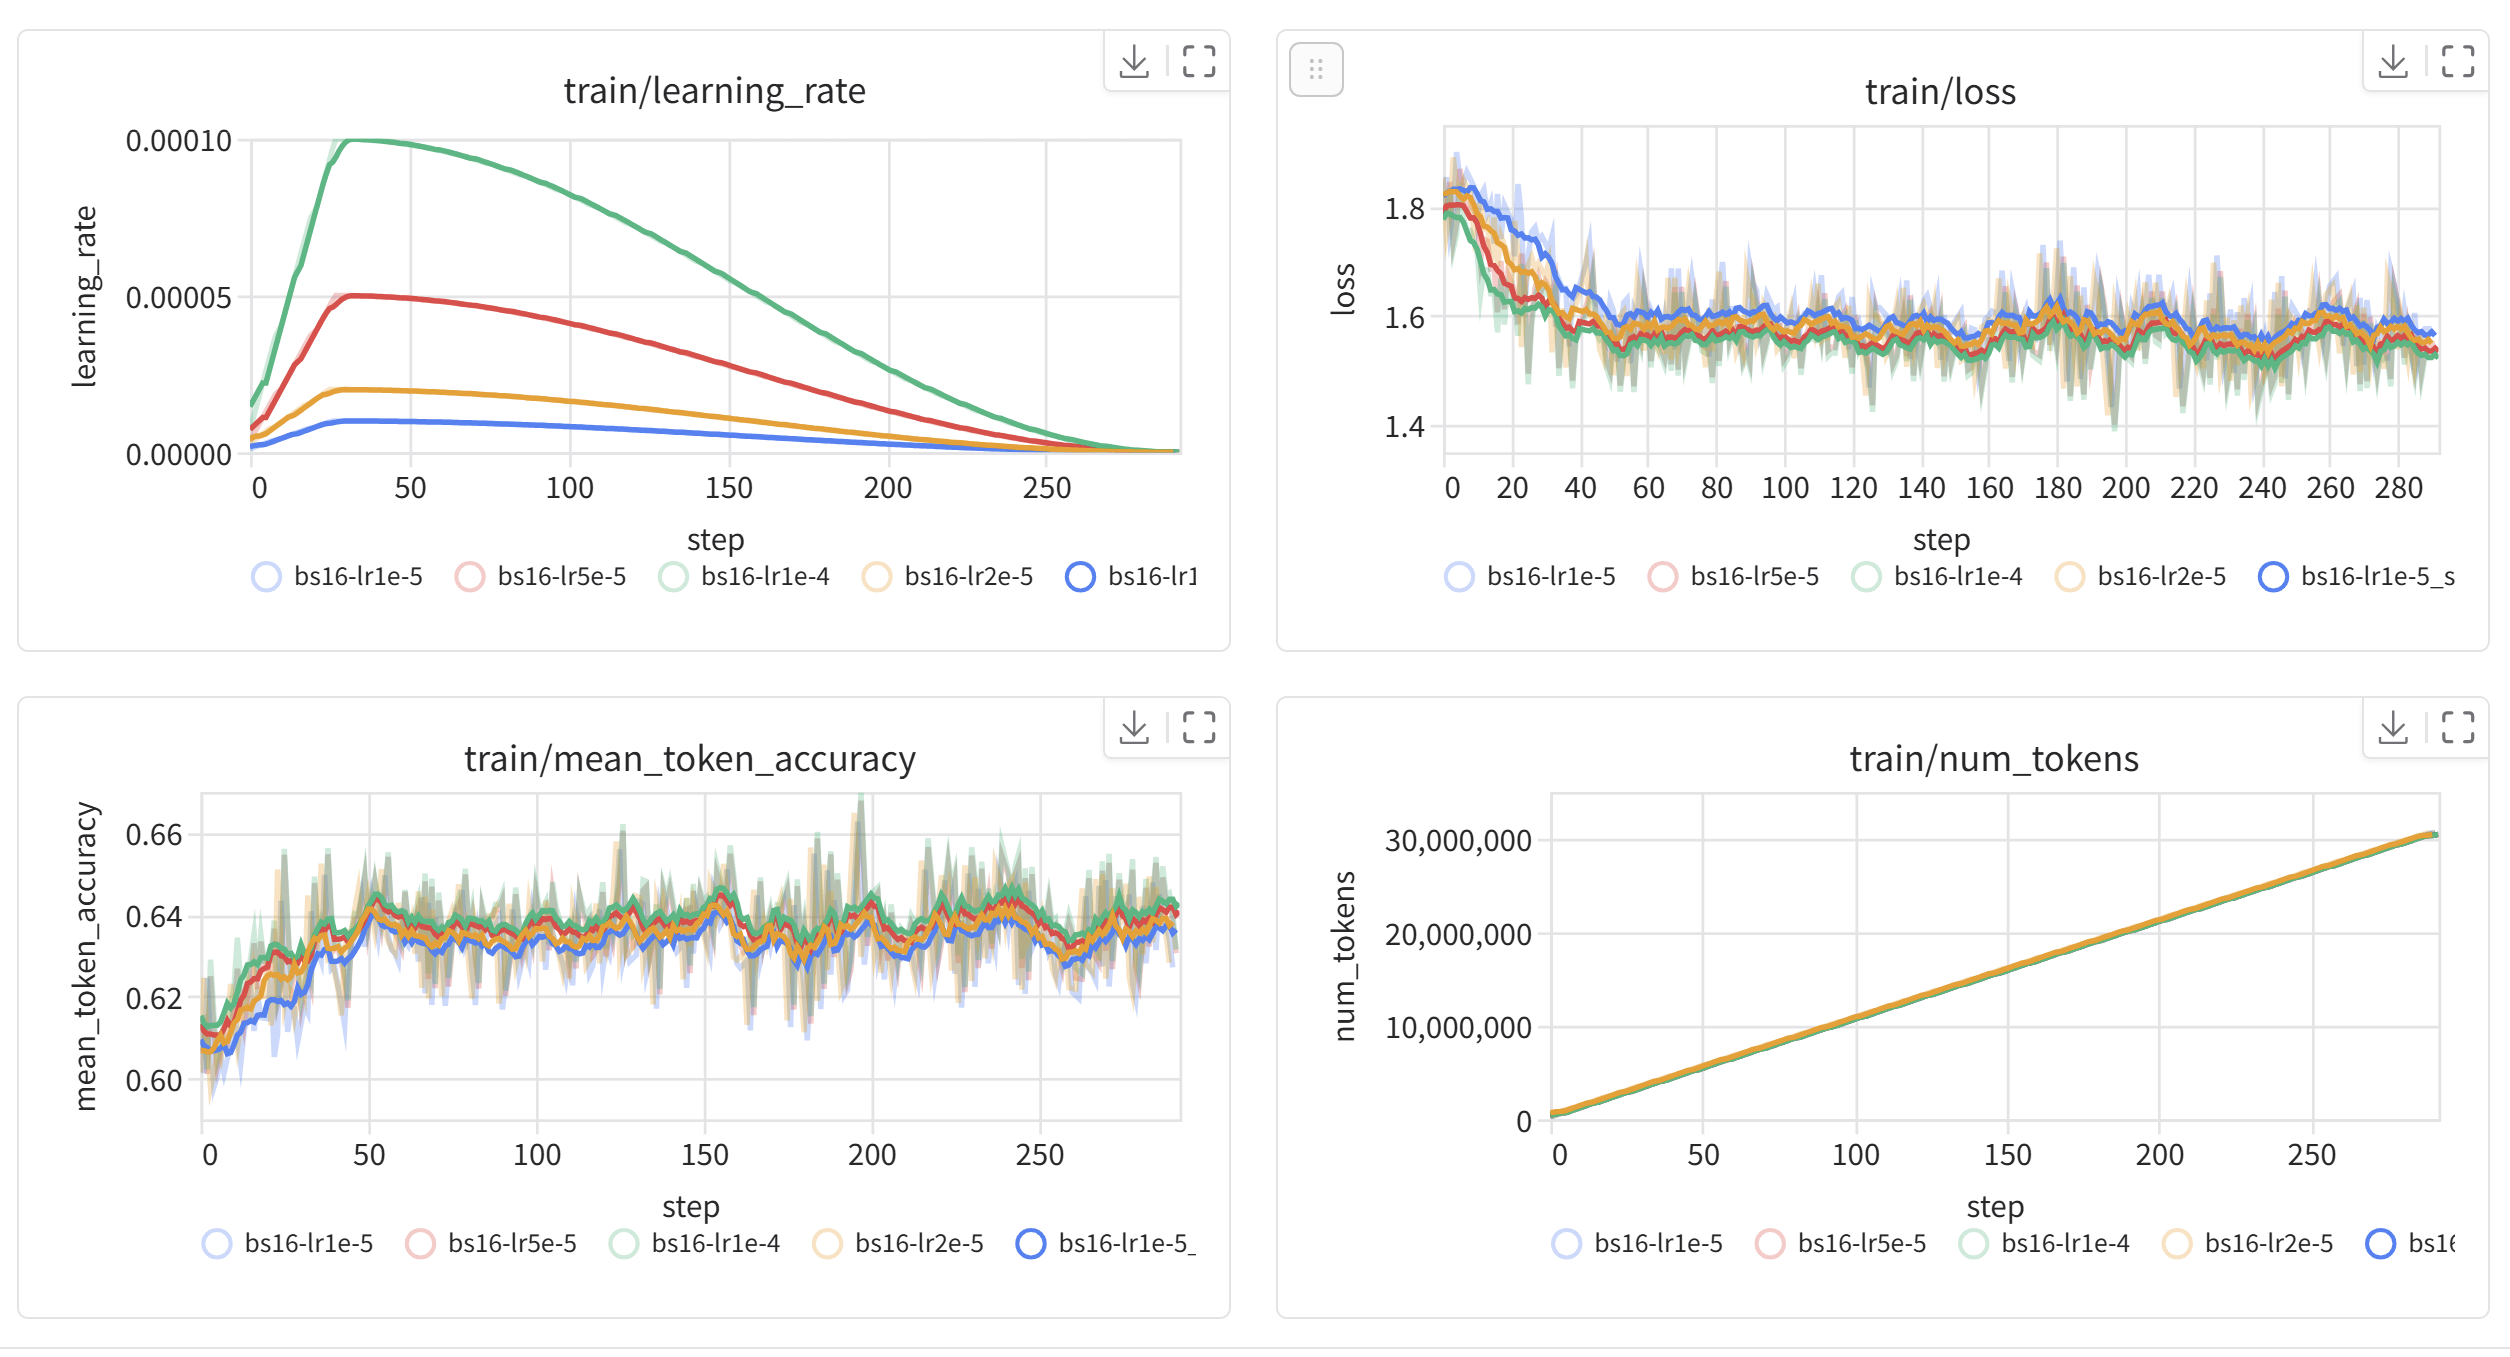
该技能集成了 Trackio,因此你可以实时观看训练损失下降。任务异步运行,所以你可以关闭终端,稍后再回来。当你想要更新时:
How's my training job doing?
然后代理会获取日志并总结进度。
使用你的模型
训练完成后,你的模型就在 Hub 上:
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("username/qwen-codeforces-cots-sft")
tokenizer = AutoTokenizer.from_pretrained("username/qwen-codeforces-cots-sft")
这就是完整闭环。你用通俗英语描述你想要的内容,代理则处理 GPU 选择、脚本生成、任务提交、身份验证和持久化。整个过程花费约三十美分。
训练方法
该技能支持三种训练方法。理解每种方法的适用场景有助于你获得更好的结果。
监督微调(SFT)
SFT 是大多数项目的起点。你提供演示数据——输入和期望输出的示例——训练会调整模型以匹配这些模式。
当你拥有想要行为的高质量示例时,请使用 SFT。客户支持对话、代码生成配对、特定领域问答——任何你可以向模型展示什么是好结果的内容。
Fine-tune Qwen3-0.6B on my-org/support-conversations for 3 epochs.
代理会验证数据集、选择硬件(对于 7B 模型使用带 LoRA 的 a10g-large),并配置带有检查点和监控的训练。
对于大于 3B 参数的模型,代理会自动使用 LoRA(低秩适应)来降低内存需求。这使得在单 GPU 上训练 7B 或 13B 模型变得可行,同时保留完整微调的大部分质量。
直接偏好优化(DPO)
DPO 基于偏好对进行训练——其中一个响应是“chosen”,另一个是“rejected”。这会使模型输出与人类偏好对齐,通常是在初始 SFT 阶段之后。
当你拥有人工标注者或自动比较生成的偏好标注时,请使用 DPO。DPO 直接针对首选响应进行优化,而不需要单独的奖励模型。
Run DPO on my-org/preference-data to align the SFT model I just trained.
The dataset has 'chosen' and 'rejected' columns.
DPO 对数据集格式很敏感。它要求列名恰好为
chosen和rejected,或者包含输入的prompt列。代理会先验证这一点,并在你的数据集使用不同名称时向你展示如何映射列。
你也可以在视觉语言模型上使用 Skills 运行 DPO!用 openbmb/RLAIF-V-Dataset 试试看。Claude 会进行一些小的修改,但训练会成功。
组相对策略优化(GRPO)
GRPO 是一种强化学习任务,已被证明在可验证任务上有效,例如解决数学问题、编写代码,或任何具有程序化成功标准的任务。
Train a math reasoning model using GRPO on the openai/gsm8k dataset based on Qwen3-0.6B.
模型生成响应,根据正确性获得奖励,并从结果中学习。这比 SFT 或 DPO 更复杂,但配置类似。
硬件与成本
代理会根据你的模型大小选择硬件,但理解其中的权衡有助于你做出更好的决策。
模型大小与 GPU 映射
对于 1B 参数以下的微型模型,t4-small 就足够了。这类模型训练很快——完整跑一次大约花费 $1-2。非常适合教学或实验性运行。
对于 小型模型(1-3B),可以升级到 t4-medium 或 a10g-small。训练需要几个小时,花费 $5-15。
对于 中型模型(3-7B),你需要使用 a10g-large 或 a100-large 配合 LoRA。全量微调放不下,但 LoRA 让这些模型变得非常可训练。生产环境下预算 $15-40。
对于 大型模型(7B 以上),这个 HF 技能任务并不适合。
演示 vs 生产
在测试一个工作流时,从小规模开始:
Do a quick test run to SFT Qwen-0.6B with 100 examples of my-org/support-conversations.
编码智能体会配置最小化训练——足以验证你的流程能跑通,而无需付出实际成本。
用于生产时,要明确说明:
SFT Qwen-0.6B for production on the full my-org/support-conversations.
Checkpoints every 500 steps, 3 epochs, cosine learning rate.
在投入数小时的生产任务之前,务必先跑一次演示。一次 $0.50 的演示如果能发现格式错误,就能省下一次 $30 的失败运行。
数据集验证
数据集格式是训练失败最常见的来源。智能体可以在你花费 GPU 时间之前先验证数据集。
Check if my-org/conversation-data works for SFT training.
智能体会在 CPU 上快速检查(花费几分钱),并报告:
Dataset validation for my-org/conversation-data:

SFT: ✓ READY
  Found 'messages' column with conversation format

DPO: ✗ INCOMPATIBLE
  Missing 'chosen' and 'rejected' columns
如果你的数据集需要转换,智能体可以向你展示如何操作:
My DPO dataset uses 'good_response' and 'bad_response' instead
of 'chosen' and 'rejected'. How do I fix this?
智能体会提供映射代码,并可以直接将其整合到你的训练脚本中。
监控训练
实时监控有助于你及早发现问题。该技能默认配置 Trackio——提交任务后,你可以在以下地址查看指标:
https://hf-mirror.com/spaces/username/trackio
这里会显示训练损失、学习率和验证指标。健康的运行会显示损失稳步下降。
随时向智能体询问状态:
What's the status of my training job?
Job abc123xyz is running (45 minutes elapsed)

Current step: 850/1200
Training loss: 1.23 (↓ from 2.41 at start)
Learning rate: 1.2e-5

Estimated completion: ~20 minutes
如果出现问题,智能体会帮助诊断。显存不足?智能体建议减小批量大小或升级硬件。数据集错误?智能体找出不匹配之处。超时?智能体建议延长时长或使用更快的训练设置。
转换为 GGUF
训练完成后,你可能想在本地运行模型。GGUF 格式可与 llama.cpp 以及 LM Studio、Ollama 等依赖工具配合使用。
Convert my fine-tuned model to GGUF with Q4_K_M quantization.
Push to username/my-model-gguf.
智能体会提交一个转换任务,合并 LoRA 适配器、转换为 GGUF、应用量化,并推送到 Hub。
然后在本地使用它:
llama-server -hf <username>/<model-name>:<quantization>

# For example, to run the Qwen3-1.7B-GGUF model on your local machine:
llama-server -hf unsloth/Qwen3-1.7B-GGUF:Q4_K_M
下一步
我们已经展示了 Claude Code、Codex 或 Gemini CLI 等编码智能体可以处理模型微调的完整生命周期:验证数据、选择硬件、生成脚本、提交任务、监控进度以及转换输出。这把过去的一项专业技能变成了你可以通过对话完成的事情。
可以尝试的一些事情:
- 在你自己的数据集上微调模型
- 通过 SFT → DPO 构建对齐偏好的模型
- 在数学或代码上用 GRPO 训练推理模型
- 将模型转换为 GGUF 并用 Ollama 运行
该技能是开源的。你可以扩展它、为你的工作流定制它,或将它作为其他训练场景的起点。
资源
来源:Hugging Face Blog · hf-mirror.com